调优笔记和踩坑记录做一次完整整合:怎么定位瓶颈、SQL 和索引怎么榨性能、秒杀库存怎么扛、什么时候才轮到分库分表,全部讲透。适合 1~5 年经验的后端同学,建议先收藏再细看。
一、先看清楚地图:优化到底该先动哪一层
实际开发中我们经常会遇到这种情况:一听说数据库扛不住,第一反应就是"上缓存、分库分表"。我之前也这么干过,后来才明白,这是拿架构复杂度去换一个本该由索引解决的问题。
如果面试官问我"高并发下 MySQL 怎么优化",我会先反问一句:"您这边是读压力大,还是写热点集中?" 这两条路的打法完全不一样。但不管哪种,整体思路都是一条线:
让 SQL 变快 → 让事务变短 → 让请求变少 → 最后才让库变多。
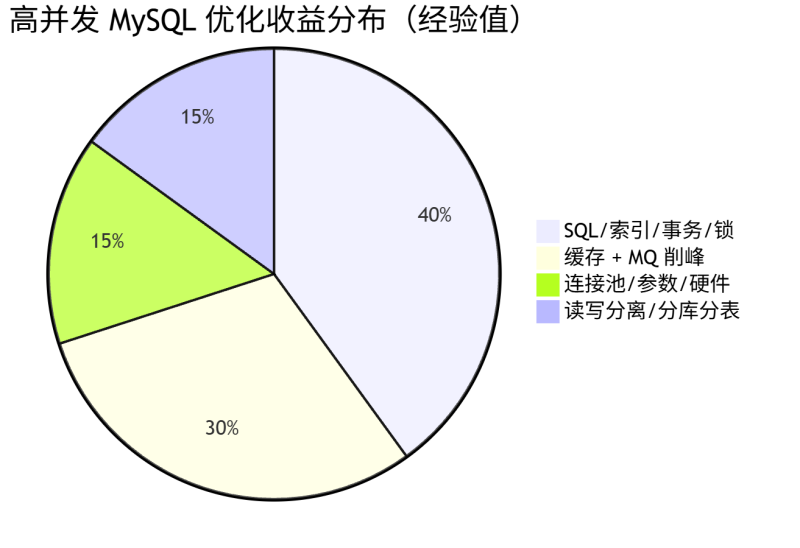
先看一张收益分布图,这是我按多年经验估的大致占比:
再把各层的手段、收益和成本拉个全景表:
| 优化层级 | 核心手段 | 性能收益 | 实施成本 | 优先级 |
|---|---|---|---|---|
| 应用层 | SQL 优化、索引优化、结果集裁剪、事务收敛 | 50%~80% | 低 | 最高 |
| 中间件层 | 缓存兜底、读写分离、MQ 削峰、分库分表 | 3~10 倍 | 中 | 高 |
| 数据库层 | InnoDB 参数调优、刷盘策略、硬件升级 | 20%~50% | 中高 | 中 |
| 架构层 | 多活部署、流量削峰、冷热分离 | 10 倍以上 | 高 | 长期建设 |
一句话原则:能靠 SQL 和索引解决的,绝不上中间件;能靠加从库解决的,绝不急着分库分表。 分库分表是架构级改动,它引入的复杂度可能比原来的慢查询更让人头疼。
地图看完了,先别急着动手——下一步是诊断,不是开药。
二、先诊断再开药:瓶颈到底在哪一层
高并发问题从来不是单一原因。拿到告警我会先问自己三个问题:
- 瓶颈到底在哪一层?CPU、IO、锁等待,还是连接数?
- 慢查询日志里最慢的 5 条 SQL 是什么?单次执行多久?
- 当前 QPS/TPS 是多少?离这台机器的容量水位还有多远?
"高并发"不是一个绝对数字。单机 MySQL 几千 QPS 和几万 QPS 的优化策略根本不是一回事,前者调调参数可能就够,后者必须动架构。上来就背"加索引、上缓存、分库分表",那叫背答案,不叫优化。
2.1 四类瓶颈,表现一样,解法完全不同
接口变慢只是表象,背后的根因可能是这四类,用索引优化去解连接风暴、用加机器去解一条慢查询,都会翻车:
| 瓶颈类型 | 典型现象 | 根因 | 第一动作 |
|---|---|---|---|
| 连接数打满 | 报"获取连接超时",max_connections 占满 | 线程上下文切换开销暴增 | 压小连接池、加快速失败 |
| 慢 SQL 拖垮 CPU | CPU 长期 >80%,慢查询日志一堆 | 索引缺失、回表、filesort | EXPLAIN + 补索引 |
| 写入刷盘跟不上 | IO util >70%,提交变慢 | redo/binlog 同步、锁竞争 | 调刷盘策略 + 批量 + 分片 |
| 单库单表触顶 | 索引层数变深,RT 从几十 ms 爬到几百 ms | B+ 树层级加深、缓冲池命中率下降 | 归档 + 读写分离 + 分库分表 |
按请求链路从下往上扫一遍,每层都有明确信号:
| 层级 | 看什么 | 典型信号 |
|---|---|---|
| SQL 层 | 慢查询、执行计划、SELECT *、隐式转换 | EXPLAIN 出现 type=ALL、Using filesort |
| 连接层 | 连接池是否打满、是否复用、有无泄漏 | max_connections 耗尽,应用侧大量获取连接超时 |
| 存储层 | Buffer Pool 命中率、磁盘 IO、redo 刷盘 | 命中率 <95%,iowait 飙高 |
| 架构层 | 读多写少?热点集中在某几行?单表是否过大? | 单表 >5000 万,或某一行被高频更新 |
2.2 我踩过的一个典型坑:CPU 不高,但接口就是慢
订单服务高峰期 RT 从 50ms 飙到 2000ms,团队方案提了一堆:升级规格、加 Redis、按天分区。结果压测一看——Threads_running 飙到 100 以上,CPU 却只有 30%。
这就说明不是算力问题,而是连接堆积导致线程上下文切换开销过大。后来把连接池最大连接数从 200 压到 50,RT 直接回落到 300ms 以内。连接池配大反而更慢,这个反直觉的坑后面第八章会展开讲。
2.3 定位决策树
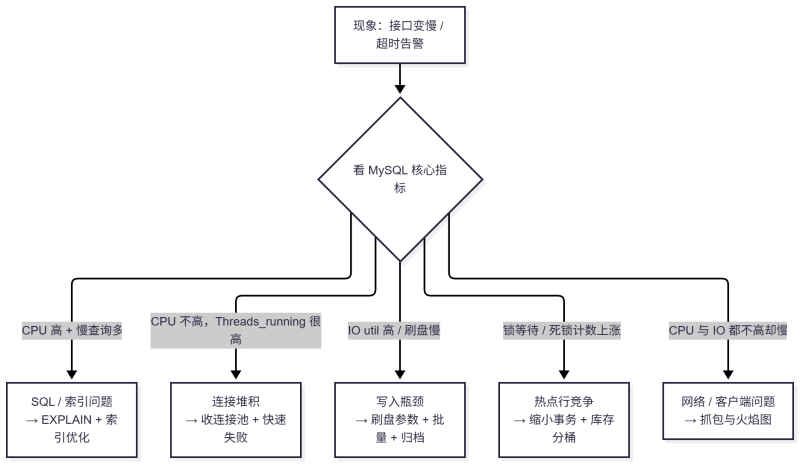
把上面的经验画成一张图,遇到告警照着走:
2.4 定位阶段的常用命令
先看数据,再下结论。这套命令我基本是肌肉记忆了:
-- ① 打开慢查询日志(生产建议 long_query_time 设 1s,交易库可设 0.1s,测试环境 0.5s)
SET GLOBAL slow_query_log = ON;
SET GLOBAL long_query_time = 1;
SET GLOBAL log_queries_not_using_indexes = ON;   -- 顺带抓未走索引的查询

-- ② 看当前正在跑什么、有没有锁等待
SHOW FULL PROCESSLIST;                            -- State 出现 Sending data / Locked 要警惕
SELECT * FROM information_schema.PROCESSLIST WHERE TIME > 3;  -- 抓当前卡住的 SQL
SELECT * FROM performance_schema.data_lock_waits; -- MySQL 8.0 查锁等待
SELECT * FROM sys.innodb_lock_waits;              -- 谁在等谁,一目了然

-- ③ 抓长事务(事务里跑 RPC 是万恶之源)
SELECT trx_id, trx_started, trx_rows_locked, trx_query
FROM information_schema.innodb_trx
WHERE trx_started < NOW() - INTERVAL 5 SECOND;

-- ④ 看执行计划与真实耗时
EXPLAIN ANALYZE
SELECT id, user_id, amount FROM orders
WHERE user_id = 10086 AND status = 1 ORDER BY create_time DESC LIMIT 20;

-- ⑤ 缓冲池命中率、锁、死锁日志
SHOW ENGINE INNODB STATUS\G   -- 搜索 "Buffer pool hit rate" / "LATEST DETECTED DEADLOCK"
⚠️ 踩坑提醒:
EXPLAIN ANALYZE(MySQL 8.0.18+)是真实执行 SQL 的,生产环境对写语句别乱用;线上优先用EXPLAIN+ 慢日志采样。
慢 SQL 聚合分析推荐 pt-query-digest,按总耗时排序,别只看单次耗时——一条单次 200ms 但每秒跑 5000 次的 SQL,比一条 3 秒才跑一次的更致命:
pt-query-digest slow.log --limit 10
完整的工具箱和监控指标放这里,建议存下来:
| 层面 | 工具 / 命令 | 看什么 |
|---|---|---|
| SQL 层 | slow_query_log、pt-query-digest | 最慢 / 最高频的几条 SQL |
| 执行计划 | EXPLAIN / EXPLAIN ANALYZE | type、key、rows、Extra |
| 运行态 | SHOW FULL PROCESSLIST、innodb_trx | 长事务、锁等待、堆积的 State |
| 引擎层 | SHOW ENGINE INNODB STATUS | Buffer pool 命中率、锁、死锁日志 |
| 指标层 | Prometheus + Grafana / PMM | QPS、TPS、连接数、慢查询数、IO util |
| 压测 | sysbench / JMeter / Gatling | 改参数前后对比,找容量水位 |
| Java 侧 | Arthas(trace / profiler)、JFR | 定位应用侧慢点,别只盯着 DB |
必看的核心指标:QPS/TPS、Threads_connected vs max_connections、Threads_running、Innodb_buffer_pool_read_requests(算命中率)、Slow_queries、Innodb_row_lock_waits、磁盘 IO util。从库延迟盯 Seconds_Behind_Source,连接池盯 HikariCP 的 pending 指标。
诊断清楚之后,从性价比最高的一层下手——SQL 和索引。
三、SQL 与索引:投入产出比最高的一层
线上 90% 的数据库性能问题都源于低效 SQL 和索引缺失。这一层成本最低、收益最大,值得花最多篇幅。
3.1 先讲原理:为什么加了索引就快
InnoDB 用 B+ 树组织索引,多路搜索把千万级数据的查询压在 3~4 层树高内。对比一下:
- vs B 树:B+ 树的非叶子节点只存索引项不存数据,同样大小的数据页能塞更多节点,树更矮,磁盘 IO 更少;
- vs 红黑树:红黑树是二叉树,千万级数据树高几十层,磁盘 IO 次数不可接受;
- B+ 树叶子节点之间还有顺序指针,天然适合范围查询。
千万级数据 = 3~4 次磁盘 IO,这就是索引快的本质。
3.2 EXPLAIN:四个字段盯死
拿到慢 SQL,EXPLAIN 走起。type 字段的性能等级链先背下来:
system > const > eq_ref > ref > range > index > ALL
  优秀 ──────────────────────────────→ 全表扫描
| 字段 | 危险信号 | 说明 |
|---|---|---|
type | ALL | 全表扫描,红线 |
key | NULL | 索引没生效 |
rows | 百万级 | 预估扫描量太大 |
Extra | Using filesort / Using temporary | 排序 / 磁盘临时表,CPU 杀手;看到 Using index 才是好东西 |
3.3 覆盖索引:省掉回表就是省掉随机 IO
先看一张图理解回表:
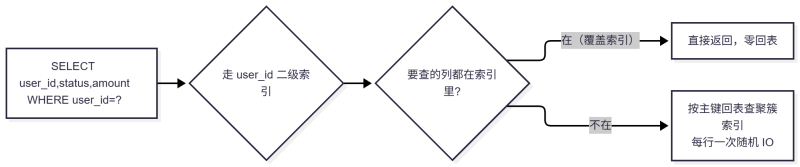
把高频查询所需的列直接放进联合索引,做成覆盖索引,就把"索引 → 主键 → 回表"三步压成一步:
-- 慢:只走 user_id,amount / status 要回表
CREATE INDEX idx_user ON orders(user_id);

-- 亮点:把查询真正用到的列都带上(Extra 出现 Using index)
CREATE INDEX idx_user_status_time_cover
    ON orders(user_id, status, create_time, amount);

EXPLAIN SELECT user_id, status, create_time, amount
FROM orders WHERE user_id = 10086 AND status = 1
ORDER BY create_time DESC LIMIT 20;
-- Extra: Using index  →  零回表
✨ 技术亮点:覆盖索引让 SQL 直接从索引树取数据,完全避免回表查询聚簇索引,单 SQL 性能可提升 2~5 倍,是性价比最高的优化手段。
3.4 复合索引与最左前缀
建了 idx(a, b, c),能命中的条件组合:
--   a           ✅ 走 a
--   a, b        ✅ 走 a+b
--   a, b, c     ✅ 全命中
--   a, c        ⚠️ 只能用到 a,c 用不上(b 断了)
--   b, c        ❌ 完全不走这个索引
建索引口诀:等值条件在前,范围条件在后,排序列紧随其后。 频繁作为 WHERE 条件且基数(区分度)高的列优先放左边。区分度 = 字段不同值数量 / 总行数。
两个容易忽略的细节:
WHERE user_id=? AND status=? ORDER BY create_time DESC→ 建(user_id, status, create_time),一次干掉过滤 + 排序,避免filesort。但注意:范围条件之后的列,排序利用会失效。- 索引不是越多越好。每个二级索引都是写放大 + 存储成本,冗余索引要定期清理。
3.5 索引失效清单(自查表)
| 写法 | 是否走索引 | 说明 |
|---|---|---|
WHERE DATE(create_time) = '2026-10-22' | ❌ | 字段上加函数;改成 >= '2026-10-22' AND < '2026-10-23' |
WHERE name LIKE '%张%' | ❌ | 前置通配符失效 |
WHERE phone = 13800138000(phone 是 varchar) | ❌ | 隐式类型转换,失效 |
WHERE status != 1 | ⚠️ | 否定 / 范围,通常全表 |
WHERE a = 1 OR b = 2 | ⚠️ | OR 两侧需都有索引,否则全表 |
ORDER BY 字段无索引 | ❌ | 触发 Using filesort |
隐式转换是我见过最隐蔽的坑:phone 是 varchar,SQL 里写成数字,索引直接失效,慢查询暴涨还查不出原因。
3.6 深分页:LIMIT 1000000, 20 到底慢在哪
MySQL 并不知道你只想要后面 20 行——它老老实实扫描前 1000020 行,排序、逐行判断,再扔掉前 100 万行。99.99% 的 IO 都白干了。我之前就遇到过运营后台导出订单,翻到第 5 万页直接把库打挂。
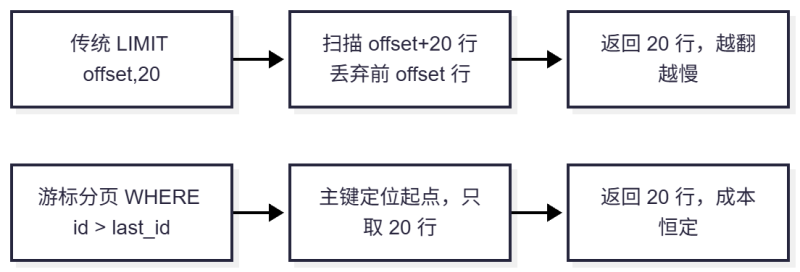
方案一:延迟关联(不能改接口、必须跳页时):
-- ❌ 慢:每跳一行都可能回表
SELECT * FROM orders ORDER BY create_time DESC LIMIT 1000000, 20;

-- ✅ 子查询只走覆盖索引捞 20 个主键,再回表取 20 次
SELECT t1.*
FROM orders t1
INNER JOIN (
    SELECT id FROM orders
    ORDER BY create_time DESC
    LIMIT 1000000, 20
) t2 ON t1.id = t2.id;
前提:
(create_time, id)要有联合索引,子查询里不能写SELECT *,JOIN 条件必须是等值连接,否则优化器会放弃覆盖索引。
方案二:游标分页(生产最稳,适合信息流 / 无限滚动):
-- 记住上一页最后一条的 id,主键索引直接定位
SELECT id, order_no, amount FROM orders
WHERE user_id = ? AND id > #{lastId}   -- 传上一页最后一条 id
ORDER BY id LIMIT 20;
-- 配合 (user_id, id) 联合索引,不管翻到第几页成本都恒定
⚠️ 游标分页的边界:排序字段必须有序且唯一(用主键兜底);只能"上一页/下一页",不能跳到第 87 页。我们当时的做法是产品侧把"跳页"改成"下一页",接口性能从 3s 降到 5ms。后台必须跳页的场景,用延迟关联 + 页数上限,或者干脆把检索能力交给 ES。
3.7 千万级大表加索引,本身也是个坑
很多人答得出怎么建索引,答不出大表怎么安全地建索引:
ALTER TABLE t_order ADD INDEX idx_user_cursor (user_id, id),
  ALGORITHM=INPLACE, LOCK=NONE;
- MySQL 5.6+ 的 Online DDL 允许并发 DML,但开始和结束瞬间仍需要短暂的 MDL 排他锁;
- 如果此时有一个未提交的长事务持有 MDL,DDL 会被阻塞,后续所有查询跟着全部阻塞,线上直接雪崩。加索引前先查有没有长事务;
- 超大表用第三方工具无锁变更,二者对比:
| 工具 | 原理 | 注意点 |
|---|---|---|
gh-ost | 依赖 ROW 格式 binlog 同步增量 | 对主库压力小,注意 binlog 格式要求 |
pt-online-schema-change | 触发器同步增量,有写放大 | 控速、避高峰、备回滚 |
3.8 两个小补充
- 优化器选错索引:偶尔会发生,可以用
FORCE INDEX(idx_xxx)或调整optimizer_switch干预,但先确认真的是选错了。 - 禁止
SELECT *,只查需要的字段——结果集裁剪本身就是优化,还能让覆盖索引更容易命中。
SQL 层讲完了。但如果你的瓶颈是写,光优化 SQL 还不够,接下来是最容易被忽略的一层:事务和锁。
四、事务与锁:最容易被忽略的隐形杀手
4.1 事务要"短、小、快"
@Transactional 里混一个 RPC 调用,是我见过最常见的"连接池杀手":
// ❌ 反例:事务里混了 RPC 调用,连接被占住 200ms 什么都没干
@Transactional
public OrderVO createOrder(Long userId) {
    Order order = buildOrder(userId);
    orderMapper.insert(order);
    UserInfo user = userClient.getUser(userId);   // 远程调用 200ms
    return toVO(order, user);
}

// ✅ 正例:先拿外部数据,再开事务,事务里只做 DB 操作
public OrderVO createOrder(Long userId) {
    UserInfo user = userClient.getUser(userId);   // RPC 放在事务外
    return txTemplate.execute(status -> {
        Order order = buildOrder(userId);
        orderMapper.insert(order);
        return toVO(order, user);
    });
}
原则:事务里不调 RPC、不发 MQ、不查无关数据、不做大循环。 @Transactional 加在方法上,别加在类上。事务每多持有连接 100ms,高并发下连接池就被多啃掉一块。
4.2 隔离级别与锁等待超时
- 隔离级别选 RC +
binlog_format=ROW,这是互联网交易场景的常见组合。RR 的间隙锁在"更新条件没命中索引"时会扩大锁范围,甚至锁到接近全表,死锁概率大幅上升。 innodb_lock_wait_timeout必须调小,设 1~3s(保守点 5~10s)。默认 50s 意味着一个热点行能把整个 Tomcat 线程池拖死。
4.3 死锁靠顺序解决,不靠 sleep 掩盖
死锁的处理四步:
- 固定加锁顺序:批量扣多个 SKU,统一按
skuId升序更新,交叉加锁是死锁的头号来源; - 缩短事务,锁持有时间越短,碰撞概率越低;
- 隔离级别降到 RC,间隙锁大幅减少;
- 只对 1213(死锁)/ 1205(锁超时) 做有限次指数退避重试。库存不足、参数非法这类错误要直接失败,无限重试只会放大流量。
⚠️ 用 sleep 和无限重试掩盖死锁,等于把炸弹埋得更深。错误日志里的
LATEST DETECTED DEADLOCK段落要定期看。
4.4 防超卖:一条 SQL 顶三段代码
"先查后减"一定超卖——两个并发请求都查到库存为 1,都判断"够",各扣一次:
// ❌ 经典错误:判断和扣减不是一个原子操作(TOCTOU 竞态)
Integer stock = stockMapper.selectStock(skuId);
if (stock >= qty) {
    stockMapper.updateStock(skuId, stock - qty);   // 并发下必然超卖
}
正确做法是把"判断"写进同一条 SQL,让 InnoDB 行锁保证原子性:
<update id="deduct">
  UPDATE sku_stock
     SET stock = stock - #{num}
   WHERE sku_id = #{skuId}
     AND stock >= #{num}
</update>
@Transactional(rollbackFor = Exception.class, timeout = 2)
public void deductStock(Long skuId, int num) {
    int rows = stockMapper.deduct(skuId, num);
    if (rows == 0) {
        throw new BizException("库存不足");  // 影响行数为 0 = 扣减失败
    }
}
✨ 技术亮点:单条
UPDATE里"判断 + 扣减"由行锁保证原子,stock >= num本身就是天然 CAS,库存场景不需要额外的 version 字段(version 适合"读-改-写整行"的场景)。用 affected rows 判断成败;事务超时设 2s,快速失败尽快释放连接。注意sku_id必须走索引,条件写得再漂亮,没索引一样锁一堆行。
三种锁方案放一起对比,选型一目了然:
| 方案 | 高并发下的表现 | 适用场景 |
|---|---|---|
悲观锁 SELECT ... FOR UPDATE | 串行排队,两次交互 + 锁持有时间长,吞吐下降 | 低并发、强一致 |
| 乐观锁 version CAS | 冲突低时吞吐高;冲突高时重试风暴打垮 DB | 读多写少、冲突低 |
条件原子 UPDATE ... WHERE stock >= n | 行锁内完成判断+扣减,无重试风暴 | 库存、余额等数值扣减 |
为什么不用 FOR UPDATE? 高竞争下连接和线程排队,吞吐反而下降;条件更新一条 SQL 就完成 CAS。为什么高并发不建议 version 乐观锁? 大量请求 CAS 失败,重试风暴比原问题更可怕。
事务和锁是慢功夫,接下来是高并发下最硬的骨头——写热点,也是这篇文章的重头戏。
五、写热点实战:秒杀库存怎么扛
如果只能挑一个场景讲透高并发写,我会选库存扣减。
5.1 问题本质:行锁的"独木桥"
UPDATE goods SET stock = stock - 1 WHERE id = 123 AND stock > 0;
这条 SQL 在 8000 QPS 下,所有请求竞争同一行的 X 锁,串行排队。事务持有锁哪怕只有 1ms,等待队列也会瞬间堆积,CPU 飙升、连接池打满,最终雪崩:
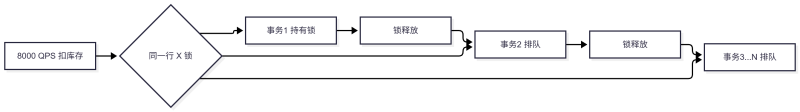
关键认知:InnoDB 行锁粒度细,但在热点行场景下,细粒度锁反而成了串行化的"放大器"。单行更新本质是串行化,加机器也没用,因为热点还在同一行。
5.2 漏斗模型:MySQL 只需要扛住真实成交
先看我们实际的秒杀链路是怎么层层过滤的:
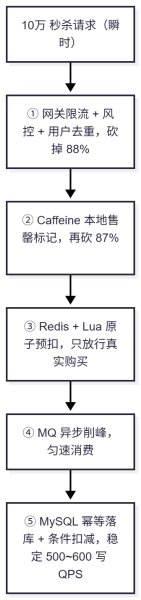
核心思想:MySQL 不需要扛 1 万 QPS,它只需要扛住"真实成交"的量。 绝大多数请求应该在网关、缓存层就被拒绝,而不是排队等数据库行锁。下面逐层拆解。
5.3 第一层:Redis Lua 原子预扣
GET 再 DECR 是两次命令,会被并发穿插;Lua 脚本让"判断 + 扣减 + 去重"原子执行,一次 RTT 搞定:
-- KEYS[1] = stock:{skuId}:{bucketId}   库存
-- KEYS[2] = dedup:{skuId}:{userId}     幂等/限购标记
-- ARGV[1] = qty  ARGV[2] = TTL秒

if redis.call('EXISTS', KEYS[2]) == 1 then
    return -2                        -- 重复请求 / 已购过,幂等返回
end
local stock = tonumber(redis.call('GET', KEYS[1]) or '-1')
if stock < 0 then return -3 end      -- 库存未预热,拒绝服务
if stock < tonumber(ARGV[1]) then
    return 0                         -- 售罄:客户端可回写本地售罄标记
end
redis.call('DECRBY', KEYS[1], ARGV[1])
redis.call('SET', KEYS[2], ARGV[1], 'EX', ARGV[2])
return 1                             -- 预扣成功
Java 侧调用,用返回值区分失败原因,前端能给准确提示:
public SeckillResult tryDeduct(Long userId, Long skuId) {
    Long code = redisTemplate.execute(DEDUCT_SCRIPT,
            Arrays.asList("stock:{" + skuId + "}:0", "dedup:{" + skuId + "}:" + userId),
            "1", "3600");
    return SeckillResult.of(code);   // 1 成功 / 0 售罄 / -2 重复 / -3 未初始化
}
这一层的坑,我替你踩过了:
- Redis Cluster 下多 key 必须落在同一 slot,用 hash tag:
stock:{sku123}:0、dedup:{sku123}:user1; - Lua 保证原子执行,但不保证失败回滚。脚本报错时已执行的写不会撤销,所以脚本要短、禁止大循环,失败靠补偿对账;
- Redis 只是挡板,不是账本:AOF
everysec可能丢秒级数据,主从异步切换也可能丢数据,最终正确性必须由 DB 的条件更新 + 唯一索引兜底(后面会讲为什么)。
8000 QPS 里 99% 在 Redis 层被拦截或拒绝,打到 MySQL 的只剩百位级。
5.4 第二层:MQ 异步下单 + 幂等落库
预扣成功的请求投进 MQ,数据库按自己的节奏匀速消费:
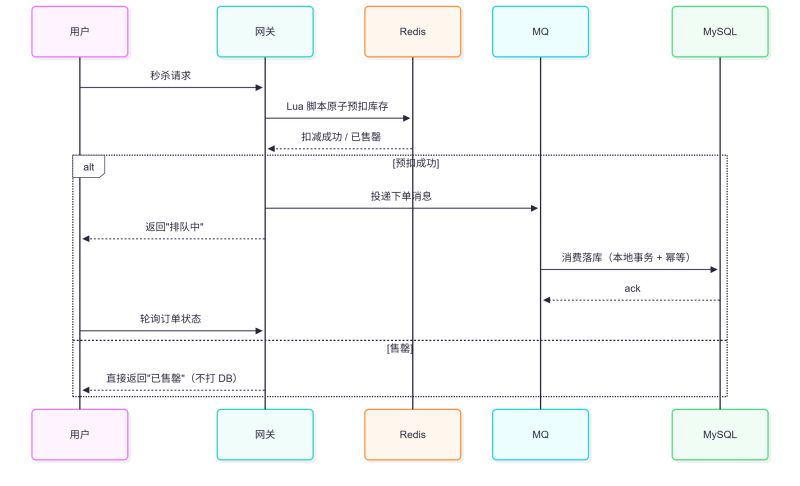
消费端是踩坑重灾区,先看代码:
// 注意:外层【没有事务】,重复消息在事务外捕获
public void onOrderMessage(OrderMsg msg) {
    try {
        orderTxService.createAndDeduct(msg);
    } catch (DuplicateKeyException e) {
        log.info("重复消息,幂等跳过: {}", msg.getOrderNo());
    }
}

@Transactional(rollbackFor = Exception.class)
public void createAndDeduct(OrderMsg msg) {
    // ① 先写订单:uk_order_no 唯一索引兜底幂等
    orderMapper.insert(msg.toOrder());
    // ② 再扣库存:条件更新,失败抛异常 → 整体回滚
    if (stockMapper.deduct(msg.getSkuId(), msg.getBucketId(), msg.getQty()) != 1) {
        throw new BizException(STOCK_NOT_ENOUGH);
    }
    detailMapper.batchInsert(msg.getItems());
}
两个高频踩坑点,都是血泪教训:
- 必须先落幂等记录(订单),再扣库存。反过来做,MQ 重试就会重复扣减;
- 在
@Transactional方法内部catch DuplicateKeyException是个陷阱:Spring 已把事务标记为rollback-only,提交时会抛UnexpectedRollbackException。正确做法是在事务外捕获,或用REQUIRES_NEW隔离。
失败处理要分类 + 有补偿:
// 落库失败 → 回补 Redis 预扣,保证最终一致
redisTemplate.execute(ROLLBACK_SCRIPT,
        Arrays.asList("stock:{" + skuId + "}:" + bucketId, "dedup:{" + skuId + "}:" + userId),
        String.valueOf(qty));
消费端还可以攒批:@KafkaListener 配合 spring.kafka.listener.type=batch 批量消费,一次 INSERT 多行,DB 压力再降一截。
5.5 第三层:库存分桶,把一行热点拆成 N 行
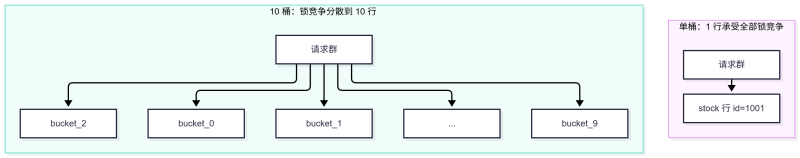
如果 Redis 预扣后仍有可观写量落到 DB,就把同一商品的库存拆到多个桶,请求随机路由,锁冲突降为 1/N:
CREATE TABLE stock_segment (
  sku_id BIGINT NOT NULL,
  seg_no TINYINT NOT NULL,      -- 把 1 行拆成 10~16 行
  stock  INT NOT NULL,
  PRIMARY KEY (sku_id, seg_no)
) ENGINE=InnoDB;

-- 扣减时随机选一个非空桶
UPDATE stock_segment
SET stock = stock - #{num}
WHERE sku_id = #{skuId}
  AND seg_no = #{segNo}
  AND stock >= #{num};
-- 返回 0 行 → 换一段重试(有限次),全部失败才判定售罄
-- 总库存 = SUM(stock),售罄判断走 Redis,不走这条聚合
private static final int SEG_COUNT = 16;

public boolean deductSeg(Long skuId, int num) {
    int seg = ThreadLocalRandom.current().nextInt(SEG_COUNT);
    return stockSegMapper.deductSeg(skuId, seg, num) > 0;
}
行锁冲突从"1 行 8000 并发"变成"16 行各 500 并发",冲突直接降一个数量级。 落地的坑比代码多:
- Redis 分桶,MySQL 也必须分桶。只在 Redis 分桶,DB 那行依然是热点,等于白干;
- 订单落库时记录
bucket_id,取消 / 超时回补必须回原桶,否则库存越补越乱,账实不符; - 桶间不均会导致"总库存有货,但分到的桶空了":做有限次(2~3 次)跨桶探测 + 后台动态调拨 + 尾桶兜底;
- 分桶数怎么定?
热点 QPS / 单行安全 TPS,再留 2 倍余量,最终以压测校准。
5.6 有云能力就用,没有别硬扛
如果用的是云 RDS,可以开启热点行自动排队优化(如阿里云 RDS / PolarDB 的 Hot Row Optimization),让热点行的锁等待在存储层做合并与排队。自建 MySQL 的话,这一层靠缩短事务 + 批量合并扣减缓解:按 SKU 聚合、按 ID 排序更新,批次 50~200 条、单事务 <50ms。注意内存合并有丢数据风险,必须持久化 + 对账。
5.7 一致性怎么兜住
| 故障点 | 方案 |
|---|---|
| Redis 扣成功,MQ 发送失败 | 事务消息 / 本地消息表 + 定时补偿回补 |
| 下单未支付 | 延迟消息关单,状态机 CAS:UPDATE t_order SET status=2 WHERE order_no=? AND status=1,回补带幂等键 |
| Redis 与 DB 库存漂移 | 每 5 分钟以 DB 为准对账修正,回补带幂等键防重复加库存 |
| 关单消息重投导致重复回补 | 订单状态机 CAS + 回补幂等键 + 回原桶 |
🎯 三层防御总结:Redis 挡掉 99% 的无效流量 → MQ 把洪峰拉平 → MySQL 的行锁 SQL 做最后一道底线。数据库永远是库存的唯一真相源,Redis 只是加速读的挡板。
高频追问:Redis 扣成功还不够吗,为什么 DB 要再扣一次? 因为 Redis 是性能组件不是账本——持久化可能丢数据、主从切换可能丢数据、Lua 不回滚,最终正确性必须由 DB 唯一索引 + 条件更新保证。为什么不用 Redis 分布式锁扣库存? 锁把并发强行串行化,Redis 单命令 / Lua 本身原子就够了,Redlock 还存在时钟与 GC 暂停的争议。
写热点讲完了。如果你的系统是读多写少(大多数系统都是),接下来的缓存章节价值更大。
六、读压力:缓存用好了,事半功倍
高并发下纯靠数据库扛不住读,必须用缓存承接 95% 以上的读流量,数据库只做持久化兜底。
6.1 多级缓存:把读流量挡在 MySQL 之前

本地缓存 Caffeine 抗住单机热点,能压掉 90% 的 Redis 调用;超级热点 key 再配合 key 分片打散 + 接口限流保护。
Cache-Aside 模式的基线实现,把穿透和雪崩的防御也埋进去了:
public ProductVO getProduct(Long id) {
    String key = "product:" + id;
    String json = redis.opsForValue().get(key);
    if (json != null) {
        return EMPTY_FLAG.equals(json) ? null : JSON.parseObject(json, ProductVO.class);
    }
    ProductVO vo = productMapper.selectById(id);
    if (vo == null) {
        redis.opsForValue().set(key, EMPTY_FLAG, 60, TimeUnit.SECONDS);  // 空值短过期,防穿透
        return null;
    }
    // 过期时间加随机扰动,避免同一时刻大面积失效(防雪崩)
    long ttl = 1800 + ThreadLocalRandom.current().nextLong(300);
    redis.opsForValue().set(key, JSON.toJSONString(vo), ttl, TimeUnit.SECONDS);
    return vo;
}
6.2 缓存三兄弟:穿透、击穿、雪崩
| 问题 | 现象 | 解法 |
|---|---|---|
| 穿透 | 查不存在的 key,请求直达 DB | 布隆过滤器拦截 + 缓存空值(短 TTL) |
| 击穿 | 单个热点 key 过期瞬间,流量打爆 DB | 互斥锁重建 / 逻辑过期异步刷新 |
| 雪崩 | 大量 key 同时过期 | 过期时间加随机扰动 / 多级缓存兜底 |
顺带说个冷知识:MySQL 8.0 为什么移除了查询缓存? Query Cache 缓存的是 SQL 完整结果集,表上任何变更都整表失效,写多读少时失效风暴反而拖垮性能。替代方案就是 Buffer Pool(缓存物理页,粒度更细)+ 应用层 Redis。
6.3 击穿的两把武器:互斥重建 vs 逻辑过期
武器一:互斥锁 + 双重检查(Redisson 实现,保证强一致读到新值):
public Order getOrder(Long orderId) {
    String key = "order:" + orderId;
    Order order = (Order) redisTemplate.opsForValue().get(key);
    if (order != null) return order;                    // 命中直接返回

    RLock lock = redissonClient.getLock("lock:order:" + orderId);
    try {
        lock.lock(3, TimeUnit.SECONDS);
        order = (Order) redisTemplate.opsForValue().get(key);  // 双重检查
        if (order != null) return order;
        order = orderMapper.selectById(orderId);        // 只放行一个请求回源
        if (order != null) {
            long ttl = 30 + ThreadLocalRandom.current().nextInt(60);  // 随机 TTL 防雪崩
            redisTemplate.opsForValue().set(key, order, ttl, TimeUnit.MINUTES);
        }
        return order;
    } finally {
        if (lock.isHeldByCurrentThread()) lock.unlock();
    }
}
✨ 技术亮点:分布式互斥锁只放行单个请求回源数据库,其余请求等缓存重建完成,既保证命中率,又避免数据库被突发流量打垮。轻量场景也可以直接用
setIfAbsent(lockKey, "1", 3, SECONDS)实现。
武器二:逻辑过期 + 异步重建(用短暂陈旧换零阻塞,大促场景这笔账划算):
public GoodsDTO getGoods(Long skuId) {
    GoodsDTO local = LOCAL_CACHE.get(skuId, k -> null);   // Caffeine 本地缓存
    if (local != null) return local;

    // Redis value 里带逻辑过期时间,物理永不过期
    RedisData rd = redis.get(GOODS_KEY + skuId);
    if (rd == null) return loadAndCache(skuId);           // 冷启动
    if (rd.getExpireAt() > System.currentTimeMillis()) {
        LOCAL_CACHE.put(skuId, rd.getData());
        return rd.getData();
    }
    // 逻辑已过期:抢互斥锁,抢到才异步重建,没抢到先返回旧值
    String lockKey = "lock:goods:" + skuId;
    if (redis.setNx(lockKey, "1", 10, TimeUnit.SECONDS)) {
        try {
            CACHE_REBUILD_EXECUTOR.submit(() -> {         // 另起线程重建,不阻塞当前请求
                GoodsDTO fresh = goodsMapper.selectById(skuId);
                redis.set(GOODS_KEY + skuId, new RedisData(fresh, nowPlus(30, MINUTES)));
                LOCAL_CACHE.put(skuId, fresh);
            });
        } finally { redis.del(lockKey); }
    }
    return rd.getData();   // 容忍短暂陈旧,换 0 阻塞
}
两种方案怎么选:
| 方案 | 一致性 | 吞吐 | 适用 |
|---|---|---|---|
| 互斥锁重建 | 读到的一定是新值 | 未拿到锁的线程要等待 | 一致性敏感的读 |
| 逻辑过期 | 短暂读到旧值 | 零阻塞,P99 稳定 | 大促热点、可容忍秒级陈旧 |
⚠️ 为什么不用"SETNX 失败后 sleep 重试"?因为会阻塞线程拖垮连接池。逻辑过期是用一致性换吞吐,选型前先想清楚业务能不能接受。
6.4 缓存与数据库一致性:别追求强一致,追求可控的最终一致
先给结论:首选"先更新 DB → 再删缓存"(Cache-Aside),删而不是更新。
@Transactional(rollbackFor = Exception.class)
public void updateUser(User user) {
    userMapper.updateById(user);                  // 1. 更新 DB
    redisTemplate.delete("user:" + user.getId()); // 2. 立即删缓存

    // 3. 延迟再删一次,覆盖主从同步 / 并发读窗口
    scheduledExecutor.schedule(() -> {
        redisTemplate.delete("user:" + user.getId());
    }, 500, TimeUnit.MILLISECONDS);
}
要求再高一级,用 Canal 伪装成从库订阅 binlog,变更事件通过 MQ 驱动缓存失效,业务代码彻底解耦:
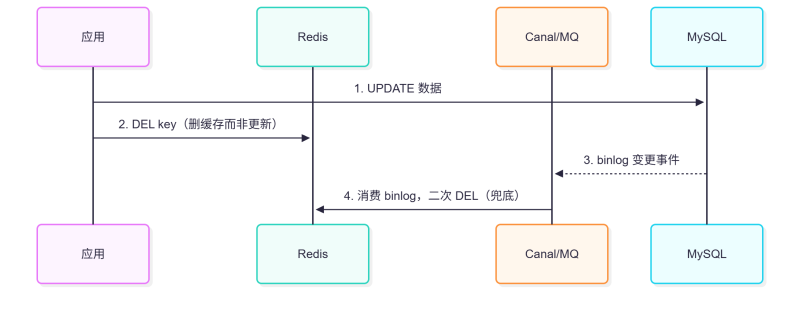
两条红线:
- ❌ 别用"先删缓存再更新 DB",并发下读请求会把旧值重新写回缓存,脏数据停留一整个 TTL;
- ❌ 别迷信延迟双删,延迟时间拍脑袋定就是赌博。binlog 订阅 + TTL 兜底 + 定时对账,才是生产级组合。
本地缓存的失效可以用 Redis Pub/Sub 广播,多实例同步清除。
写到这里文章已经过半,能读到这里的都是认真想提升的同学。这个号会持续更新这类一线实战内容,觉得有用的话可以点个关注,下次更新不迷路。
接下来讲读写分离——读优化的另一半。
七、读写分离:别让"刚写的查不到"变成事故
高并发场景 80% 以上是读请求,通过主从复制把读流量分摊到从库,主库只扛写。读写分离能快速把主库 CPU 从 90% 压到 40% 以下。
7.1 透明化实现:业务代码零侵入
基于 ThreadLocal + AbstractRoutingDataSource,配合 AOP 注解自动切换:
/**
 * 动态数据源上下文(线程隔离)
 */
public class DynamicDataSourceContextHolder {
    private static final ThreadLocal<String> HOLDER = new ThreadLocal<>();
    public static void set(String type) { HOLDER.set(type); }
    public static String get() { return HOLDER.get(); }
    public static void clear() { HOLDER.remove(); }
}

/**
 * 动态数据源路由
 */
public class DynamicRoutingDataSource extends AbstractRoutingDataSource {
    @Override
    protected Object determineCurrentLookupKey() {
        return DynamicDataSourceContextHolder.get();
    }
}
✨ 技术亮点:ThreadLocal + AbstractRoutingDataSource 实现透明读写分离,再配一个自定义
@ReadFromSlave注解 + AOP 切面自动切换,业务代码零侵入,是中小团队落地的首选方案。
7.2 主从延迟:必须直面的暗坑
写完立刻读从库,读到旧数据,"用户刚下的单查不到"就是线上事故。处理手段按场景选:
| 应对手段 | 适用场景 | 说明 |
|---|---|---|
| 写后读强制走主库 | 下单后立刻查订单 | 最简单有效:@Transactional(readOnly = false)、Hint 强制路由或会话粘性 |
| GTID 位点等待 | 需要精确等待复制完成 | WAIT_FOR_EXECUTED_GTID_SET 等到从库追上位点再读 |
| 半同步复制 | 一致性要求较高 | 至少一个从库 ack 才提交,降低延迟窗口 |
| 并行复制 | 主库写入并发高 | 调大 replica_parallel_workers / slave_parallel_workers,提升回放吞吐 |
| 延迟降级回主库 | 从库延迟超阈值(如 3s) | 宁可主库多扛一点,也不能让用户看到脏数据 |
| 级联复制 | 从库过多,主库 binlog 压力大 | 主 → 从 → 从,分摊主库复制压力 |
| 读旧数据可接受 | 商品列表、评论 | 允许短暂不一致,直接走从库 |
一句话记忆:写后读走主库,能容忍延迟的走从库。 绝不"写完立刻读从库"。
7.3 架构演进的完整路径
把缓存和读写分离放进来,一个系统扛流量的演进路线通常是这样的:

每一层都是上一层扛不住了才上的——这也是全文反复强调的节奏。还有一层常被忽略但收益不小:连接池和批量写。
八、连接池与批量写:最反直觉的坑
8.1 连接池不是越大越好
把连接池想象成餐厅的座位,并发请求是客人:座位太少客人排队,座位太多——服务员来回跑动反而上菜更慢。当活跃连接数超过 CPU 核心数后,线程切换成本急剧上升,再加连接带来的不是吞吐提升,而是响应时间恶化。这就是为什么 200 个连接比 20 个还慢。
HikariCP 的核心参数不是拍脑袋:
spring:
  datasource:
    url: jdbc:mysql://db:3306/trade?rewriteBatchedStatements=true&cachePrepStmts=true&prepStmtCacheSize=500&characterEncoding=utf8mb4
    hikari:
      maximum-pool-size: 20        # 公式:CPU核数 × 2 + 有效磁盘数,先别超 50
      minimum-idle: 20             # 核心链路与 maximum 保持一致,避免峰值临时建连
      connection-timeout: 3000     # 拿不到连接就快速失败,别干等 30s
      validation-timeout: 1000
      idle-timeout: 600000
      max-lifetime: 1740000        # 必须小于 MySQL wait_timeout,留 30s 余量
      keepalive-time: 60000
      leak-detection-threshold: 60000  # 连接泄漏检测,见下方说明
关键点逐个说:
maximumPoolSize用(CPU × 2) + 磁盘数估算,一般 10~30 起步,以压测拐点为准;- 总连接数 = 池大小 × 应用实例数。20 × 50 个实例 = 1000 连接,DB 直接被打爆。多实例部署时所有实例的总连接数必须小于 MySQL
max_connections,且max_connections还要给运维留 20% 余量; maxLifetime必须小于 MySQL 的wait_timeout,否则连接被服务端单方面关闭后应用还在用,出现"连接突然不可用";connection-timeout设 3s 快速失败,配合熔断降级,别让请求排队等连接——排队只会把雪崩放大;- 泄漏检测有争议:排查阶段建议开
leak-detection-threshold: 60000抓泄漏;但有一种观点认为高并发生产环境不宜长开,因为每次触发要遍历整个连接池。我们的做法是生产开 60s 阈值 + 观察开销,按自己系统情况取舍。
8.2 批量写:写入场景的性价比之王
// ❌ 1000 次网络往返 + 1000 次事务提交
for (OrderLog log : logs) { orderLogMapper.insert(log); }
<!-- ✅ 一条 SQL 批量插入,网络往返和提交次数都降到 1/N -->
<insert id="batchInsert" parameterType="list">
    INSERT INTO order_log(order_id, op, create_time) VALUES
    <foreach collection="list" item="i" separator=",">
        (#{i.orderId}, #{i.op}, now())
    </foreach>
</insert>
也可以用 MyBatis 的 BATCH 模式:
sqlSessionTemplate.execute(session -> {
    OrderItemMapper mapper = session.getMapper(OrderItemMapper.class);
    for (OrderItem item : list) {
        mapper.insert(item); // ExecutorType.BATCH
    }
    session.flushStatements();
    return null;
});
实测数据:1 万条单条插入 6.2s → 批量 100 条/批 0.4s,提升 15 倍。
批量的三条硬约束:
- 单批别超过 500~1000 条,避免超过
max_allowed_packet和长事务; - JDBC URL 加
rewriteBatchedStatements=true,驱动才会把多条INSERT合并成VALUES (),(),(),网络往返从 N 次降为 1 次,写入提速 5~10 倍; - 注意它只重写批量 INSERT,批量 UPDATE 不会合并成一条,别指望它优化扣库存。
连接和写入理顺了,最后才是参数调优这个"临门一脚"。
九、InnoDB 参数:锦上添花的最后一公里
前提:参数调优是最后的收益点,一定要在 SQL 和索引优化之后再做。顺序反了就是本末倒置。
核心参数清单:
# 内存(专用数据库,别和应用混部)
innodb_buffer_pool_size = 12G          # 物理内存的 60%~75%,独占机 OLTP 可到 80%,至少留 2G 给 OS
innodb_buffer_pool_instances = 8       # 拆分缓冲池,减少并发访问锁竞争

# IO 刷盘(性能与持久性的权衡)
innodb_flush_log_at_trx_commit = 2     # 金融/交易用 1;可容忍秒级丢失用 2,性能提升 30%+
sync_binlog = 1000                     # 组提交减少 fsync;与上一条配合,金融场景双 1

# 并发与锁
transaction_isolation = READ-COMMITTED # 降级隔离级别,大幅减少锁冲突
innodb_autoinc_lock_mode = 2           # 自增锁优化,批量插入性能翻倍
innodb_lock_wait_timeout = 5           # 高并发下别让锁等待拖死请求
max_connections = 2000                 # 按峰值 +20% 冗余,但应用侧连接池要远小于它
thread_cache_size = 100                # 复用连接线程,减少创建开销

# SSD 专项
innodb_flush_neighbors = 0             # SSD 必关,机械盘才需要邻居页一起刷
innodb_io_capacity = 2000              # SSD 别用默认 200,NVMe 可设 2000~5000 甚至更高

# 临时表
tmp_table_size = 64M
max_heap_table_size = 64M              # 减少磁盘临时表 Created_tmp_disk_tables
几个必须讲透的权衡和坑:
- 双 1 保命:
innodb_flush_log_at_trx_commit = 1+sync_binlog = 1是数据安全的底线组合。改成 2 / 1000 能换明显的 TPS 提升,但掉电可能丢秒级事务——交易、支付链路禁用,日志、埋点这类可容忍丢失的场景放心用。 - Buffer Pool 命中率是核心 KPI:通过
Innodb_buffer_pool_read_requests监控,目标 ≥99%(至少 99.5%)。持续偏低说明内存不够用,先加内存再谈别的。 - 一个容易翻车的细节:
innodb_buffer_pool_size必须是innodb_buffer_pool_chunk_size × instances的整数倍,否则启动时会被自动向下取整,你以为设了 12G 实际只有 11G。
参数是最后一块拼图。当上面所有层都榨干了还是扛不住,才轮到架构层的大杀器——分库分表。
十、分库分表:最后的手段,不是银弹
10.1 什么时候才该动
问题驱动,不是技术潮流驱动,也不是"单表 2000 万"这种玄学数字。 真正的触发信号是这些:
- 单表数据量持续超 1000 万~2000 万行(有场景到 5000 万),B+ 树层级加深、RT 明显爬升;
- 连接池配到 50 还是频繁报"获取连接超时";
- 单库写入吞吐到顶:
Threads_running高、binlog 同步延迟、锁竞争加剧、单库 TPS 持续超 5000; - 磁盘容量顶不住,历史数据归档也缓解不了。
反过来,如果只是偶发慢查询,先做三件事:优化 SQL、补索引、上读写分离。很多号称"要分库分表"的问题,其实是缺一个复合索引。
10.2 分片键选择:选错等于白忙
| 候选分片键 | 评价 | 原因 |
|---|---|---|
user_id | 首选 | C 端查询天然聚合,分布均匀 |
order_id + user_id 组合 | 推荐 | 按用户路由,订单号全局唯一 |
create_time | 避免 | 时间递增 → 写入全打到最新分片,形成热点 |
UUID | 避免 | 字符串散列不均,索引效率低 |
自增 id | 慎用 | 新数据集中最后一片,且丧失按用户查询能力 |
status 等低区分度字段 | 避免 | 数据倾斜 + 跨片聚合 |
既要按买家查又要按卖家查怎么办?两个办法:订单号里嵌入 user_id 的分片位(基因法,如 shard = buyer_id % 16 编入订单号尾部),让"按订单号查"也能精准路由;卖家维度的列表查询走 Canal → ES 异构索引,不跨片扫。
10.3 ShardingSphere-JDBC 配置
Java 技术栈下 ShardingSphere-JDBC 是首选:内嵌应用层,无中心化节点、零额外网络开销和部署成本,分片逻辑在 JDBC 层完成,运维成本极低。
spring:
  shardingsphere:
    datasource:
      names: ds0,ds1
      ds0: { type: com.zaxxer.hikari.HikariDataSource, jdbc-url: jdbc:mysql://db0:3306/order, username: app, password: *** }
      ds1: { type: com.zaxxer.hikari.HikariDataSource, jdbc-url: jdbc:mysql://db1:3306/order, username: app, password: *** }
    rules:
      sharding:
        tables:
          t_order:
            actual-data-nodes: ds$->{0..1}.t_order_$->{0..3}   # 2 库 × 4 表 = 8 片
            database-strategy:                                  # 分库:user_id 取模
              standard:
                sharding-column: user_id
                sharding-algorithm-name: db-inline
            table-strategy:                                     # 分表:order_id 取模
              standard:
                sharding-column: order_id
                sharding-algorithm-name: tbl-inline
            key-generate-strategy:
              column: order_id
              key-generator-name: snowflake                     # 分布式主键,别用 UUID
        sharding-algorithms:
          db-inline:  { type: INLINE, props: { algorithm-expression: ds$->{user_id % 2} } }
          tbl-inline: { type: INLINE, props: { algorithm-expression: t_order_$->{order_id % 4} } }
        key-generators:
          snowflake: { type: SNOWFLAKE, props: { worker-id: 1 } }
    props:
      sql-show: false
分片算法也可以自定义,比如按 user_id 取模路由:
public class OrderDbSharding implements PreciseShardingAlgorithm<Long> {
    @Override
    public String doSharding(Collection<String> dbNames,
                             PreciseShardingValue<Long> shardingValue) {
        long userId = shardingValue.getValue();
        return "ds" + (userId % dbNames.size());
    }
}
分片算法选型上,哈希取模分布均匀、实现简单,范围分片适合时间维度查询但容易热点,按场景选。
10.4 四个必然代价,动手前想清楚
- 跨库 JOIN 变分布式问题:禁止不带分片键的全表扫描;宽表冗余字段避免跨库 join,或者应用层组装;
- 本地事务变分布式事务:选型见下面的对比表;
- 深分页要归并所有分片结果:跨片
ORDER BY + LIMIT 100000内存和 RT 双爆炸。解法是强制带分片键路由到单片、各分片取前 N 条内存归并 TopK、各片游标 + 归并,或者干脆交给 ES 的search_after; - 扩容迁移是大工程:取模分片扩容需要全量数据迁移。
分布式事务选型对比:
| 方案 | 一致性 | 性能 | 适用 |
|---|---|---|---|
| Seata XA | 强一致 | 低,资源锁定时间长 | 金融级强一致场景 |
| Seata AT | 准强一致 | 中 | 一般业务;注意核心交易链路无脑上 AT,全局锁会变成新的热点 |
| 本地消息表 / 事务消息 | 最终一致 | 高 | 非核心链路,互联网业务首选 |
10.5 扩容、全局 ID 与数据倾斜
- 扩容:推荐成倍数扩容(2→4→8),数据迁移用双写 + 灰度切流;更稳的做法是上线就按 32 个逻辑分片规划,物理机少放几片,扩容只是逻辑分片搬家。一致性哈希也能减少迁移量;
- 全局 ID:雪花算法必须处理时钟回拨 + workerId 分配;号段模式推荐 Leaf 双 Buffer,DB 抖动时仍能发号。用 Snowflake / Leaf 还能避免自增 ID 导致的主键热点和页分裂;
- 数据倾斜:上线前压测各分片行数偏差控制在 ±15% 内;出现热点分片可以单独拆分、引入二级分片、分片键加盐
hash(uid + suffix),或缓存兜底热点数据。
10.6 不动分库分表也能续命的招
| 手段 | 适用 | 关键点 |
|---|---|---|
| 垂直拆分 | 大字段(详情、图片)拖慢扫描 | 冷字段拆子表,主表变瘦,一页装更多行 |
| 分区表 / 归档 | 日志、历史订单 | 按时间分区,冷数据转 OSS / History 库 |
| 读写分离加从库 | 读压力大 | 横向扩读,成本低于分片 |
| 非核心功能降级 | 大促保命 | 评价、推荐先关,保交易主链路 |
先归档、分区、索引优化,再谈分片。 这一步做对了,可能根本不用分库分表。
架构拆完了,怎么证明优化真的有效?答案是压测和上线闭环。
十一、压测验证与上线闭环:不裸奔
优化做完不算完,所有优化都要过一遍:压测 + 灰度 + 回滚预案。
压测要看 P99 / P999、错误率、Threads_running、锁等待、主从延迟,不看平均 RT——平均值会骗人。条件允许就做全链路压测 + 影子库表 + 压测标透传,用 JMeter / Gatling / sysbench 对比改参数前后的容量水位。
我们秒杀系统优化前后的真实数据:
| 指标 | 优化前 | 优化后 |
|---|---|---|
| 接口 P99 | 1.2s | 85ms |
| DB 写 QPS | 3200(已打满) | 600(有余量) |
| 超卖 | 3 单 | 0 |
| 死锁 | 12 次/小时 | 0 |
| 慢 SQL | 800 条/分钟 | <5 条/分钟 |
另一次订单库治理:P99 从 2100ms 降到 95ms,打到 DB 的 QPS 从 3 万降到 4000,慢查询清零。还有一次单条 2.1s 的全表扫描 + filesort,加联合索引 + 延迟关联后降到 12ms。
上线动作五连:灰度放量 → 开关可降级(排队页/只读模式)→ 监控告警 → 对账兜底 → 可回滚。
hotspot 治理之外,更要建立长效机制,别让问题复发:
- 慢查询阈值设 100ms 并接入告警;
- SQL 上线前强制
EXPLAIN评审; - 有条件的话上 SQL 治理平台,自动拦截全表扫描。
十二、总结:一张速记卡 + 几句掏心窝的话
把全文浓缩成一张速记卡:
定位先行  →  看 CPU / IO / Threads_running / 慢 SQL,别拍脑袋改参数
索引为王  →  B+树 3~4 层,复合索引最左前缀,覆盖索引免回表,别让函数毁掉索引
SQL 收尾  →  深分页用延迟关联或游标,批量代替循环,少 SELECT *
事务要短  →  连接数 ≈ core*2,事务里别调 RPC,RC + ROW binlog,锁超时调小
热点打散  →  Redis Lua 预扣 → MQ 异步 → 库存分桶 → SQL 原子扣减兜底
读靠缓存  →  多级缓存 + 三兄弟防御,先更库后删缓存 + Canal 兜底
参数最后  →  buffer pool 60%~75%,SSD 提 io_capacity,刷盘看业务容忍度
架构克制  →  读写分离 → 分库分表(问题驱动,分片键选 user_id)
兜底思维  →  数据库永远是唯一真相源,一致性靠对账,不靠自觉
回头看,这套东西真正值钱的不是某个技术名词,而是三个意识:先定位再动手的克制、主动讲清代价的权衡、用数据说话的闭环。 最能扛流量的架构,往往不是最复杂的那个,而是把每一个"不必要的数据库访问"都消灭掉的那个。
高并发优化的本质,不是让 MySQL 跑得更快,而是让它少干活。
最后两个落地建议:一是把第二章的定位命令和第九章的参数清单存下来,下次告警直接照着走;二是如果你的系统还没到分库分表的量级,先把索引和事务这两件事做到极致,收益比你想的大得多。











