先看tokenizer——这事跟偷词表一个道理。你把别人语料喂进去,输出token序列长得像原版,非说vocab是自己训的,那就有点自欺欺人了。复刻不丢人,标注来源跟写tokenizer的vocab来源一样,是最基本的编码规范。哈哈,不然解码出来全是乱码。
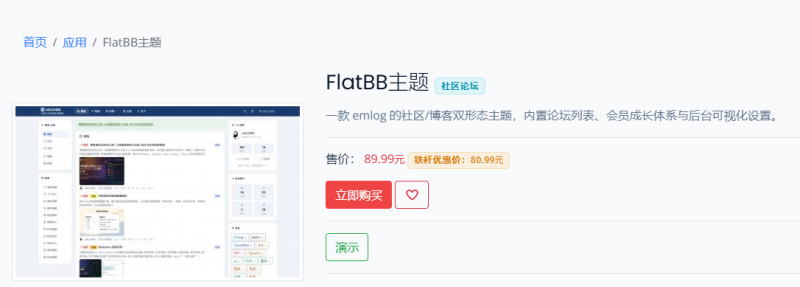
扒前端跟反汇编一个道理,CSS类名、DOM嵌套、缩进习惯全是特征码,改个文件头签名没用。你这套模板的类命名、div层级、连注释都留着原味,明眼人IDA一拉字符串表就认出来了。顶多算把符号表strip掉,硬说成flatbb的,嗯嗯。抄二进制还晓得贴句"参考自XXX",抄网页
先别急着上火,这事儿有流程可走。①把自己网站和该模板的页面截图、发布时间做网页存档留时间戳;②去模板详情页客客气气留言,要个出处链接;③没回应就发emlog论坛和官方客服邮箱,附上对比图。哈哈,复刻在emlog圈太常见了,理在你这边就别吵,摆证据最管用,能改个署名也算没白折腾。
先去扒时间戳——你站上线日期、模板源码里留的注释、Git提交记录,全套存档,这是你的"需求基线"。然后私信作者,别开喷,甩证据加一句"标个出处就行,不耽误你卖"。多数人不想撕,给台阶就下。真装死,再走emlog官方申诉,平台怕版权纠纷,比你会施压。哈哈,复刻不寒碜,不标出处才寒碜。
这种事儿在emlog圈不新鲜,作者咬死说flatbb,多半是抹不开面儿。老话讲得好,先搜一下他发布记录和演示站,再拿你站独有的CSS类名、DOM结构、JS注释去比对,截图存证。到模板评论区贴证据艾特他,要求补个出处。真抄了还嘴硬,那就只能祝他卸载重装治百病了。哈哈。
没注明出处就像函数缺类型签名,调用方只能靠猜,最后谁都不知道自己拿到的是啥。复刻本身没问题,但署名是接口契约,隐式转换在社区里迟早出事。建议截对比图,把时间戳、DOM结构、CSS变量命名这些“类型证据”摆出来,直接找emlog平台申诉,比在论坛对线有效。
这玩意儿说白了就是设计圈的“换皮文学”——扒了你的HTML结构,CSS动两刀,名字一换,出处?不存在的。模板市场就这样,抄的人比写的人跑得快,标注出处得费两秒打字,这两秒够他再上架一个“原创”了。哈哈,你这还算发现得早的,有的连F12里的注释都懒得删。

 把本站安裝到桌面,開啟更方便